GMM(混合ガウスモデル)とは? 定義からEMアルゴリズムの完全導出まで
Gaussian Mixture Model & EM Algorithm
GMMとは
定義: GMM(Gaussian Mixture Model, 混合ガウスモデル)
GMM(Gaussian Mixture Model, 混合ガウスモデル)とは、データの確率分布を複数の正規分布(ガウス分布)の重み付き和として表現する確率モデルである。
$$p(\boldsymbol{x}) = \sum_{k=1}^{K} \pi_k \, N(\boldsymbol{x} \mid \boldsymbol{\mu}_k, \boldsymbol{\Sigma}_k)$$
ここで $K$ は正規分布の個数、$\pi_k$ は混合比($\pi_k\geq 0$ かつ $\sum_k \pi_k = 1$)、$\boldsymbol{\mu}_k$ は平均ベクトル、$\boldsymbol{\Sigma}_k$ は対称正定値な分散共分散行列である。以下、正規分布の密度は $N(\boldsymbol{x} \mid \boldsymbol{\mu},\boldsymbol{\Sigma})$ と書く。
直感的な理解
単一の正規分布ではうまく表せない「山が複数ある」データ分布を考える。GMM では、まず潜在変数がどの成分から生成されるかを選び、選ばれた成分の条件付き分布が正規分布になると考える。結果として密度は、各山に対応する正規分布を混合比 $\pi_k$ で重み付けて足し合わせた形になり、複雑な分布を柔軟に近似できる。パラメータの推定には EMアルゴリズム(Expectation-Maximization)を用いる。
 図1: 3つの正規分布から生まれたデータ(左の散布図)を、混合正規分布(GMM)で表したもの。各クラスタがそれぞれ一つの山となり、全体は確率密度 $p(\boldsymbol{x})$ の3D曲面(右)になる。GMM は、向きも広がりも異なる正規分布の重み付き和で、複数の山を持つ分布を柔軟に近似する。
応用分野
- クラスタリング: K-meansと異なり、各データ点が複数クラスタに確率的に所属できる(ソフトクラスタリング)
- 異常検知: 正常データの密度をGMMで学習し、低確率領域の点を異常と判定
- 音声認識: 話者の音声特徴量のモデリング
- 画像処理: 背景/前景分離、テクスチャセグメンテーション
- 密度推定: カーネル密度推定のパラメトリック版として
はじめに(本稿の方針)
上記の概要で述べたGMMについて、本稿ではEMアルゴリズムによるパラメータ推定を途中計算を一切省略せず完全に導出する。
具体的には、平均ベクトル、分散共分散行列、混合比のそれぞれについて、対数尤度関数の偏微分から停留条件を導き、パラメータの更新式を得るまでの全ステップを行列微分を用いて厳密に示す。
分散共分散行列の導出では精度行列(逆行列)を経由し、行列式の微分と二次形式の微分を組み合わせる手法を採用している。
混合比の推定ではラグランジュ乗数法による制約付き最適化を用い、最後に ELBO(変分下界)と KL ダイバージェンスに基づく EM アルゴリズムの収束証明を掲載する。
以下、太字はベクトルまたは行列を表し、行列 $\boldsymbol{A}$ の逆行列の転置を $\boldsymbol{A}^{-T}=\left(\boldsymbol{A}^{-1}\right)^T$ と略記する。
正規分布
$D$ 次元の正規分布は、平均ベクトル $\boldsymbol{\mu}\in\mathbb{R}^D$、対称正定値な分散共分散行列 $\boldsymbol{\Sigma}\in\mathbb{R}^{D\times D}$ をパラメータとして持ち、次のように表される。正定値でないと $|\boldsymbol{\Sigma}|>0$ が言えず、$|\boldsymbol{\Sigma}|^{-\frac{1}{2}}$ が実数として定まらないうえ、指数部が上に非有界となって密度が可積分でなくなる。
\begin{eqnarray}
N(\boldsymbol{x}|\boldsymbol{\mu},\boldsymbol{\Sigma})
&=& (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}|^{-\frac{1}{2}}\exp\left\{-\frac{1}{2}(\boldsymbol{x}-\boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1}(\boldsymbol{x}-\boldsymbol{\mu})\right\} \label{Normal}
\end{eqnarray}
混合正規分布
混合正規分布を、正規分布 $N(\boldsymbol{x}|\boldsymbol{\mu},\boldsymbol{\Sigma})$ の線形結合として、次のように定義する。
\begin{eqnarray}
p(\boldsymbol{x}) &=& \sum_{k=1}^K \pi_k N(\boldsymbol{x}|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k) \label{GMM}
\end{eqnarray}
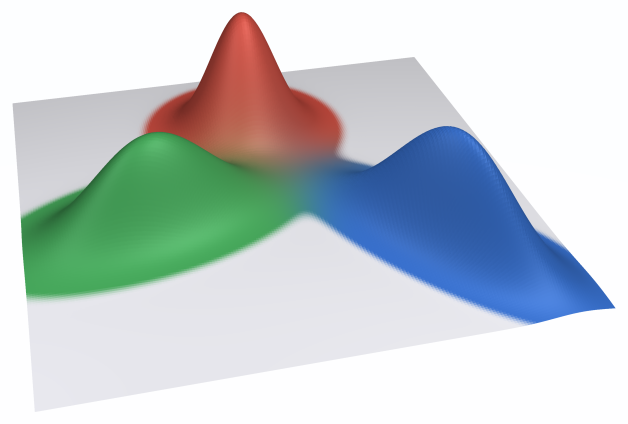 図2: $K=3$ の混合正規分布 $p(\boldsymbol{x})=\displaystyle\sum_{k=1}^{3}\pi_k N(\boldsymbol{x}|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)$ の密度面。
各成分 $\pi_k N(\boldsymbol{x}|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)$ が一つの山に対応し、結合係数 $\pi_k$ と共分散 $\boldsymbol{\Sigma}_k$ が山の高さと広がりを決める。色は各成分への負担率(事後確率) $\gamma_{n,k}=\dfrac{\pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)}{\displaystyle\sum_j \pi_j N(\boldsymbol{x}_n|\boldsymbol{\mu}_j,\boldsymbol{\Sigma}_j)}$ の大きさを表し、成分色(赤・青・緑)の混色で示している。重なりのある領域では所属は確率的であり、色の境目は最大の負担率を持つ成分を選んで硬く分類したときの決定境界にあたる。
ただし、結合係数 $\pi_k$ は確率に対応するもので、
\begin{eqnarray}
0\leq \pi_k\leq 1
\end{eqnarray}
かつ
\begin{eqnarray}
\sum_{k=1}^K \pi_k &=& 1 \label{sumpi1}
\end{eqnarray}
を満たすものとする。
混合正規分布モデルの対数尤度関数
観測されたサンプル $\boldsymbol{x}_n\in\mathbb{R}^D,\ n=1,2,3,\cdots N$ が式(\ref{GMM})の混合正規分布モデルから出てきたものと仮定し、その対数尤度関数
\begin{eqnarray}
\log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma})
&=& \log \prod_{n=1}^N p(\boldsymbol{x}_n) \\
&=& \sum_{n=1}^N \log p(\boldsymbol{x}_n) \\
&=& \sum_{n=1}^N \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)
\end{eqnarray}
を大きくするパラメータ $\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma}$ の組を推定する。
ただし、この対数尤度関数は上に有界ではない。ある成分の平均を 1 つのデータ点に一致させたまま、その成分の分散共分散行列を退化させると対数尤度はいくらでも大きくなる(縮退解)ので、大域的な最大値は存在しない。
したがって以下で求めるのは 1 階の必要条件(勾配が $\boldsymbol{0}$)を満たす停留点であり、2 階の条件は扱わない。実用上は、正則化や初期値の工夫によって縮退解を避けたうえで、意味のある停留点を探すことになる。
ここで $\boldsymbol{X}$ はサンプル集合 $\{\boldsymbol{x}_1, \boldsymbol{x}_2, \cdots \boldsymbol{x}_N\}$ を行列で表したものである。
\begin{eqnarray}
\boldsymbol{X}
&=& \left(
\begin{array}{ccc}
& \boldsymbol{x}_1^T & \\
& \boldsymbol{x}_2^T & \\
& \vdots & \\
& \boldsymbol{x}_N^T & \\
\end{array}
\right) \in \mathbb{R}^{N\times D}
\end{eqnarray}
パラメータ推定の方針としては、対数尤度関数の停留点では、すべての $m=1,2,3,\cdots K$ で
\begin{eqnarray}
\left\{
\begin{array}{rcl}
\displaystyle\frac{\partial}{\partial\boldsymbol{\mu}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma}) &=& 0\\
\displaystyle\frac{\partial}{\partial\boldsymbol{\Sigma}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma}) &=& 0\\
\displaystyle\frac{\partial}{\partial\pi_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma}) &=& 0
\end{array}
\right.
\end{eqnarray}
が成り立つことを利用する。
負担率
$z_n \in \{1, 2, \cdots, K\}$ をサンプル $\boldsymbol{x}_n$ がどの正規分布から生成されたかを示す潜在変数とし、$P(z_n = m) = \pi_m$ とする。
サンプル $\boldsymbol{x}_n$ が $m$ 番目の正規分布から出てきた事後確率をベイズの定理で計算すると
\begin{eqnarray}
\gamma_{n,m}
&=& \frac{P(\boldsymbol{x}_n | z_n = m) P(z_n = m)}{\displaystyle\sum_{k=1}^K P(\boldsymbol{x}_n | z_n = k) P(z_n = k)} \nonumber\\
&=& \frac{N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m) \cdot \pi_m}{\displaystyle\sum_{k=1}^K N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k) \cdot \pi_k} \label{gamma}
\end{eqnarray}
となり、これを負担率と呼ぶことにする。
なお、サンプル $\boldsymbol{x}_n$ は $K$ 個ある正規分布のどれかから出てきたわけであるから、$m=1,2,3,\cdots K$ について $\gamma_{n,m}$ を足し合わせた全確率は当然のことながら 1 になる。
\begin{eqnarray}
\require{cancel}
\sum_{m=1}^K \gamma_{n,m}
&=& \sum_{m=1}^K \frac{\pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{i=1}^K \pi_i N(\boldsymbol{x}_n|\boldsymbol{\mu}_i,\boldsymbol{\Sigma}_i)} \\
&=& \frac{\cancel{\displaystyle\sum_{m=1}^K \pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}}{\cancel{\displaystyle\sum_{m=1}^K \pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}} \\
&=& 1 \label{sumgamma}
\end{eqnarray}
対数尤度関数の停留条件から $\boldsymbol{\mu}_m$ を求める
この節では、対数尤度関数を平均ベクトルで偏微分し、二次形式のベクトル微分を適用して停留条件を解く。
結果として、各クラスタの平均ベクトルはサンプルの負担率による重み付き平均として得られる。
以下の導出では分母レイアウト記法を採用する。すなわち、スカラー関数をベクトルで微分した結果は列ベクトルとなる。
対数尤度関数を $\boldsymbol{\mu}_m$ で偏微分すると
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\mu}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma})
&=& \frac{\partial}{\partial\boldsymbol{\mu}_m} \sum_{n=1}^N \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k) \\
&=& \sum_{n=1}^N \frac{\partial}{\partial\boldsymbol{\mu}_m} \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k) \\
&& \text{一般に } \log'(f(\boldsymbol{x}))=\frac{f'(\boldsymbol{x})}{f(\boldsymbol{x})} \text{ であるから} \nonumber\\
&=& \sum_{n=1}^N \frac{\displaystyle\frac{\partial}{\partial\boldsymbol{\mu}_m} \displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)} \\
&& k\neq m \text{ の場合、}\frac{\partial}{\partial\boldsymbol{\mu}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)=0 \text{ であるので} \nonumber\\
&=& \sum_{n=1}^N \frac{\pi_m \displaystyle\frac{\partial}{\partial\boldsymbol{\mu}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)} \label{dmu}
\end{eqnarray}
ここで式(\ref{Normal})から、正規分布 $N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)$ は
\begin{eqnarray}
N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)
&=& (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}_m|^{-\frac{1}{2}}\exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \nonumber \\
&& \boldsymbol{\mu}_m \text{ で偏微分することを考慮して } \boldsymbol{x} \text{ と } \boldsymbol{\mu} \text{ を入れ替え} \nonumber\\
&=& (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}_m|^{-\frac{1}{2}}\exp\left\{-\frac{1}{2}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\}
\end{eqnarray}
これにより、式(\ref{dmu})の分子の $\pi_m$ の後ろは次のように書ける。
\begin{eqnarray}
&&\frac{\partial}{\partial\boldsymbol{\mu}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m) && \nonumber\\
&&\hspace{3em}= \frac{\partial}{\partial\boldsymbol{\mu}_m} (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}_m|^{-\frac{1}{2}} \exp\left\{-\frac{1}{2}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\} \nonumber\\
&&\hspace{3em}= (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}_m|^{-\frac{1}{2}} \frac{\partial}{\partial\boldsymbol{\mu}_m} \exp\left\{-\frac{1}{2}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\} \nonumber\\
&&\hspace{4em} \text{一般に } \exp'(f(\boldsymbol{x}))=\exp(f(\boldsymbol{x}))f'(\boldsymbol{x}) \text{ であるから} \nonumber\\
&&\hspace{3em}= (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}_m|^{-\frac{1}{2}} \exp\left\{-\frac{1}{2}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\} \nonumber\\
&&\hspace{3em} \quad \times \frac{\partial}{\partial\boldsymbol{\mu}_m}
\left\{-\frac{1}{2}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\} \nonumber\\
&&\hspace{3em}= N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)
\frac{\partial}{\partial\boldsymbol{\mu}_m}
\left\{-\frac{1}{2}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\} \nonumber\\
&&\hspace{3em}= -\frac{1}{2} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)
\frac{\partial}{\partial\boldsymbol{\mu}_m}
\left\{(\boldsymbol{\mu}_m-\boldsymbol{x}_n)^T\boldsymbol{\Sigma}_m^{-1}(\boldsymbol{\mu}_m-\boldsymbol{x}_n)\right\} \\
&&\hspace{4em} \text{一般に } \displaystyle\frac{\partial\boldsymbol{x}^T \boldsymbol{A} \boldsymbol{x}}{\partial\boldsymbol{x}}=(\boldsymbol{A}+\boldsymbol{A}^T)\boldsymbol{x} \text{ であるから}^* \nonumber\\
&&\hspace{3em}= -\frac{1}{2} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)
\left(\boldsymbol{\Sigma}_m^{-1}+\boldsymbol{\Sigma}_m^{-T}\right) (\boldsymbol{\mu}_m-\boldsymbol{x}_n) \\
&&\hspace{4em} \text{分散共分散行列 } \boldsymbol{\Sigma}_m \text{ は対称行列であるから } \boldsymbol{\Sigma}_m^{-1} \text{ も対称行列なので} \nonumber\\
&&\hspace{3em} \left(\boldsymbol{\Sigma}_m^{-1}+\boldsymbol{\Sigma}_m^{-T}\right)=2 \boldsymbol{\Sigma}_m^{-1} \nonumber\\
&&\hspace{3em}= - N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m) \boldsymbol{\Sigma}_m^{-1} (\boldsymbol{\mu}_m-\boldsymbol{x}_n) \\
&&\hspace{3em}= N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m) \boldsymbol{\Sigma}_m^{-1} (\boldsymbol{x}_n-\boldsymbol{\mu}_m)
\end{eqnarray}
* $\displaystyle\frac{\partial\boldsymbol{x}^T \boldsymbol{A} \boldsymbol{x}}{\partial\boldsymbol{x}}=(\boldsymbol{A}+\boldsymbol{A}^T)\boldsymbol{x}$ の 証明
よって式(\ref{dmu})は
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\mu}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma})
&=& \sum_{n=1}^N \frac{\pi_m \displaystyle\frac{\partial}{\partial\boldsymbol{\mu}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)} \nonumber\\
&=& \sum_{n=1}^N \frac{\pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)} \boldsymbol{\Sigma}_m^{-1} (\boldsymbol{x}_n-\boldsymbol{\mu}_m)
\end{eqnarray}
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\mu}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma})
&=& \sum_{n=1}^N \gamma_{n,m} \boldsymbol{\Sigma}_m^{-1} (\boldsymbol{x}_n-\boldsymbol{\mu}_m) \\
&& \text{停留点では勾配が } \boldsymbol{0} \text{ となるので} \nonumber\\
&=& \boldsymbol{0}
\end{eqnarray}
が成り立つには
\begin{eqnarray}
\sum_{n=1}^N \gamma_{n,m} \boldsymbol{\Sigma}_m^{-1} \boldsymbol{x}_n
&=& \sum_{n=1}^N \gamma_{n,m} \boldsymbol{\Sigma}_m^{-1} \boldsymbol{\mu}_m
\end{eqnarray}
両辺に左から $\boldsymbol{\Sigma}_m$ を掛けて
\begin{eqnarray}
\sum_{n=1}^N \gamma_{n,m} \boldsymbol{x}_n
&=& \sum_{n=1}^N \gamma_{n,m} \boldsymbol{\mu}_m
\end{eqnarray}
よって
\begin{eqnarray}
\boldsymbol{\mu}_m
&=& \frac{\displaystyle\sum_{n=1}^N \gamma_{n,m} \boldsymbol{x}_n}{\displaystyle\sum_{n=1}^N \gamma_{n,m}}
\end{eqnarray}
対数尤度関数の停留条件から $\boldsymbol{\Sigma}_m$ を求める
この節では、分散共分散行列についての停留条件を解く。
直接微分が困難なため、精度行列(逆行列)を変数として対数尤度を書き換え、行列式の対数の微分と外積形式の二次形式の微分を組み合わせることで解を得る。
結果は、負担率で重み付けされた偏差の外積の平均となる。
なお $\boldsymbol{\Sigma}_m$ は対称正定値なので、その逆行列である精度行列 $\boldsymbol{\Gamma}_m=\boldsymbol{\Sigma}_m^{-1}$ も対称正定値であり、$|\boldsymbol{\Gamma}_m|^{\frac{1}{2}}$ は実数として定まる。
また以下では $\boldsymbol{\Gamma}_m$ の $D^2$ 個の成分をすべて独立と見なして微分する。対称性の制約を課すと非対角成分の変化率は 2 倍になるが、勾配が $\boldsymbol{0}$ となる点は変わらないため、停留条件としては同じ結果を与える。
分散共分散行列 $\boldsymbol{\Sigma}_m$ の逆行列を
\begin{eqnarray}
\boldsymbol{\Gamma}_m=\boldsymbol{\Sigma}_m^{-1}
\end{eqnarray}
と置くと
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\Sigma}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma})\ =\ \boldsymbol{0}
\end{eqnarray}
を満たす解は
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Gamma}^{-1})\ =\ \boldsymbol{0}
\end{eqnarray}
を解くことで計算できる。
これは、$\boldsymbol{\Sigma}\mapsto\boldsymbol{\Sigma}^{-1}$ が対称正定値行列の集合上の全単射であり、その微分が正則であることによる。連鎖律より、一方の勾配が $\boldsymbol{0}$ となる点と他方の勾配が $\boldsymbol{0}$ となる点は一致する。
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Gamma}^{-1})
&=& \frac{\partial}{\partial\boldsymbol{\Gamma}_m} \sum_{n=1}^N \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1}) \\
&=& \sum_{n=1}^N \frac{\partial}{\partial\boldsymbol{\Gamma}_m} \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1}) \\
&& \text{一般に } \log'(f(\boldsymbol{x}))=\frac{f'(\boldsymbol{x})}{f(\boldsymbol{x})} \text{ であるから} \nonumber\\
&=& \sum_{n=1}^N \frac{\displaystyle\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1})}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1})} \\
&& k\neq m \text{ の場合、}\frac{\partial}{\partial\boldsymbol{\Gamma}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1})=0 \text{ であるので} \nonumber\\
&=& \sum_{n=1}^N \frac{\pi_m \displaystyle\frac{\partial}{\partial\boldsymbol{\Gamma}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Gamma}_m^{-1})}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1})} \label{dgamma}
\end{eqnarray}
式(\ref{Normal})から、正規分布 $N(\boldsymbol{x}|\boldsymbol{\mu},\boldsymbol{\Sigma})$ は
\begin{eqnarray}
N(\boldsymbol{x}|\boldsymbol{\mu},\boldsymbol{\Sigma})
&=& (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Sigma}|^{-\frac{1}{2}}\exp\left\{-\frac{1}{2}(\boldsymbol{x}-\boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1}(\boldsymbol{x}-\boldsymbol{\mu})\right\} \nonumber
\end{eqnarray}
であるから、式(\ref{dgamma})の分子の $\pi_m$ の後ろは次のように書ける。
\begin{eqnarray}
&& \frac{\partial}{\partial\boldsymbol{\Gamma}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Gamma}_m^{-1}) \nonumber\\
&=& (2\pi)^{-\frac{D}{2}} \frac{\partial}{\partial\boldsymbol{\Gamma}_m}|\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \label{dNdG}
\end{eqnarray}
一般に $\{f(\boldsymbol{x})g(\boldsymbol{x})\}'=f'(\boldsymbol{x})g(\boldsymbol{x})+f(\boldsymbol{x})g'(\boldsymbol{x})$ であることから、$\displaystyle\frac{\partial}{\partial\boldsymbol{\Gamma}_m}$ 以降は次のように書ける。
\begin{eqnarray}
&& \left(\frac{\partial}{\partial\boldsymbol{\Gamma}_m} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}}\right) \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \nonumber\\
&& + |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \left[\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \right] \label{ddGm}
\end{eqnarray}
前半の ( ) 内は
\begin{eqnarray}
\frac{\partial}{\partial\boldsymbol{\Gamma}_m} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}}
&=& \frac{1}{2} |\boldsymbol{\Gamma}_m|^{-\frac{1}{2}} \frac{\partial}{\partial\boldsymbol{\Gamma}_m} |\boldsymbol{\Gamma}_m| \\
&& \text{一般に } \frac{\partial|\boldsymbol{X}|}{\partial\boldsymbol{X}}=|\boldsymbol{X}|\boldsymbol{X}^{-T} \text{ であるので}^* \nonumber\\
&=& \frac{1}{2} |\boldsymbol{\Gamma}_m|^{-\frac{1}{2}} |\boldsymbol{\boldsymbol{\Gamma}_m}|\boldsymbol{\boldsymbol{\Gamma}_m}^{-T} \\
&=& \frac{1}{2} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}}\boldsymbol{\boldsymbol{\Gamma}_m}^{-T}
\end{eqnarray}
* $\displaystyle\frac{\partial|\boldsymbol{X}|}{\partial\boldsymbol{X}}=|\boldsymbol{X}|\boldsymbol{X}^{-T}$ の 証明
後半の [ ] 内は
\begin{eqnarray}
&&\hspace{-2em}\displaystyle\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \\
&& \hspace{2em}\text{一般に } \exp'(f(\boldsymbol{x}))=\exp(f(\boldsymbol{x}))f'(\boldsymbol{x}) \text{ であるので} \nonumber\\
&& \hspace{2em}=\exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\}
\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \\
&& \hspace{2em}\text{一般に } \displaystyle\frac{\partial\boldsymbol{a}^T \boldsymbol{X} \boldsymbol{a}}{\partial\boldsymbol{X}}=\boldsymbol{a}\boldsymbol{a}^T \text{ であるから}^* \nonumber\\
&& \hspace{2em}=-\frac{1}{2}
\exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\}
(\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\end{eqnarray}
* $\displaystyle\frac{\partial\boldsymbol{a}^T \boldsymbol{X} \boldsymbol{a}}{\partial\boldsymbol{X}}=\boldsymbol{a}\boldsymbol{a}^T$ の 証明
よって式(\ref{ddGm})は
$E_{n,m} = \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\}$ と略記すると
\begin{eqnarray}
&& \hspace{-2em}\left(\frac{\partial}{\partial\boldsymbol{\Gamma}_m} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}}\right) E_{n,m}
+ |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \left(\frac{\partial}{\partial\boldsymbol{\Gamma}_m} E_{n,m} \right) \\
&& \hspace{2em}=\frac{1}{2} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \boldsymbol{\Gamma}_m^{-T} E_{n,m}
- \frac{1}{2} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} E_{n,m} (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T \\
&& \hspace{2em}\text{共通因子 } |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} E_{n,m} \text{ はスカラーなので括り出せて} \nonumber\\
&& \hspace{2em}=\frac{1}{2} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} E_{n,m}
\left\{
\boldsymbol{\Gamma}_m^{-T}
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\}
\end{eqnarray}
式(\ref{dNdG})は、$(2\pi)^{-\frac{D}{2}}$ を式(\ref{ddGm})に掛けたものであるから
\begin{eqnarray}
&& \hspace{-2em}\frac{\partial}{\partial\boldsymbol{\Gamma}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Gamma}_m^{-1}) \nonumber\\
&& \hspace{2em}=(2\pi)^{-\frac{D}{2}} \frac{\partial}{\partial\boldsymbol{\Gamma}_m}|\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \nonumber\\
&& \hspace{2em}\text{式(\ref{ddGm})を代入して} \nonumber\\
&& \hspace{2em}=\frac{1}{2} (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \exp\left\{-\frac{1}{2}(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T\boldsymbol{\Gamma}_m(\boldsymbol{x}_n-\boldsymbol{\mu}_m)\right\} \nonumber\\
&& \hspace{2em}\quad \times \left\{
\boldsymbol{\Gamma}_m^{-T}
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\} \nonumber\\
&& \hspace{2em}\text{上記の } (2\pi)^{-\frac{D}{2}} |\boldsymbol{\Gamma}_m|^{\frac{1}{2}} \exp\{\cdots\} \text{ 部分は } N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m) \text{ なので} \nonumber\\
&& \hspace{2em}=\frac{1}{2} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)
\left\{
\boldsymbol{\Gamma}_m^{-T}
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\} \label{ddGN}
\end{eqnarray}
よって、式(\ref{dgamma})は
\begin{eqnarray}
&& \hspace{-2em}\frac{\partial}{\partial\boldsymbol{\Gamma}_m} \log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Gamma}^{-1}) \nonumber\\
&& \hspace{2em}=\sum_{n=1}^N \frac{\pi_m \displaystyle\frac{\partial}{\partial\boldsymbol{\Gamma}_m} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Gamma}_m^{-1})}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1})} \nonumber\\
&& \hspace{2em}\text{式(\ref{ddGN})を代入して} \nonumber\\
&& \hspace{2em}=\frac{1}{2}
\sum_{n=1}^N \frac{\pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Gamma}_k^{-1})}
\left\{
\boldsymbol{\Gamma}_m^{-T}
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\} \\
&& \hspace{2em}\boldsymbol{\Gamma}_m \text{ は } \boldsymbol{\Sigma}_m \text{ の逆行列なので } \boldsymbol{\Gamma}_m^{-T}=\boldsymbol{\Sigma}_m^T \nonumber\\
&& \hspace{2em}=\frac{1}{2}
\sum_{n=1}^N \frac{\pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)}
\left\{
\boldsymbol{\Sigma}_m^T
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\} \\
&& \hspace{2em}\text{式(\ref{gamma}) の } \gamma_{n,m} \text{ を使って書けば} \nonumber\\
&& \hspace{2em}=\frac{1}{2}
\sum_{n=1}^N \gamma_{n,m}
\left\{
\boldsymbol{\Sigma}_m^T
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\} \\
&& \hspace{2em}\boldsymbol{\Sigma}_m \text{ は対称行列なので } \boldsymbol{\Sigma}_m^T=\boldsymbol{\Sigma}_m \nonumber\\
&& \hspace{2em}=\frac{1}{2}
\sum_{n=1}^N \gamma_{n,m}
\left\{
\boldsymbol{\Sigma}_m
- (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\right\} \\
&& \hspace{2em}\text{停留点では勾配が } \boldsymbol{0} \text{ となるので} \nonumber\\
&& \hspace{2em}=\boldsymbol{0}
\end{eqnarray}
とすると
\begin{eqnarray}
\sum_{n=1}^N \gamma_{n,m}
\boldsymbol{\Sigma}_m
&=& \sum_{n=1}^N \gamma_{n,m}
(\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\end{eqnarray}
より、以下を得る。
\begin{eqnarray}
\boldsymbol{\Sigma}_m
&=& \frac{1}{\displaystyle\sum_{n=1}^N \gamma_{n,m}}
\sum_{n=1}^N \gamma_{n,m}
(\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T
\end{eqnarray}
対数尤度関数の停留条件から $\pi_m$ を求める
この節では、混合比(混合係数)についての停留条件を解く。
混合比は総和が 1 という等式制約を持つため、ラグランジュ乗数法を用いた制約付き最適化として定式化し、乗数を消去して閉じた形の解を得る。
混合係数 $\pi_m$ は $\displaystyle\sum_{m=1}^K \pi_m=1$ を満たさねばならないという強い制約があるため、Lagrange の未定乗数法により、対数尤度関数に $\lambda\left(\displaystyle\sum_{k=1}^K \pi_k -1\right)$ を加えたものの停留点を求めることにする。
以下では $\pi_m>0$ の内点解を仮定する。停留条件に $1/\pi_m$ が現れるため、$\pi_m=0$ の境界ではこの導出は使えず、$N_m=0$ となる空成分では更新式そのものが定義できない(実装ではその成分を削除するか再初期化する)。
なお不等式制約 $0\leq\pi_k\leq 1$ を改めて課す必要はない。得られる $\pi_m=N_m/N$ は、$\gamma_{n,m}\geq 0$ と $\displaystyle\sum_{m=1}^K N_m=N$ から自動的にこれを満たすからである。
\begin{eqnarray}
&& \hspace{-2em}\frac{\partial}{\partial\pi_m} \left\{\log p(\boldsymbol{X}|\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma}) + \lambda\left(\sum_{k=1}^K \pi_k -1\right)\right\} \nonumber\\
&& \hspace{2em}=\left\{\frac{\partial}{\partial\pi_m} \sum_{n=1}^N \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)\right\}+\lambda \\
&& \hspace{2em}=\left\{\sum_{n=1}^N \frac{\partial}{\partial\pi_m} \log \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)\right\}+\lambda \\
&& \hspace{2em}\text{一般に } \log'(f(\boldsymbol{x}))=\frac{f'(\boldsymbol{x})}{f(\boldsymbol{x})} \text{ であるから} \nonumber\\
&& \hspace{2em}=\sum_{n=1}^N \frac{\displaystyle\frac{\partial}{\partial\pi_m} \sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)} +\lambda \\
&& \hspace{2em}k\neq m \text{ の場合、}\frac{\partial}{\partial\pi_m} \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)=0 \text{ であるので} \nonumber\\
&& \hspace{2em}=\sum_{n=1}^N \frac{N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)}+\lambda \\
&& \hspace{2em}\text{式(\ref{gamma}) の } \gamma_{n,m} \text{ を使って書けば} \nonumber\\
&& \hspace{2em}=\frac{1}{\pi_m} \sum_{n=1}^N \gamma_{n,m}+\lambda \\
&& \hspace{2em}=0
\end{eqnarray}
とすると、両辺に $\pi_m$ を掛けて
\begin{eqnarray}
\sum_{n=1}^N \gamma_{n,m} + \pi_m \lambda &=& 0
\end{eqnarray}
より
\begin{eqnarray}
\pi_m &=& -\frac{1}{\lambda} \sum_{n=1}^N \gamma_{n,m} \label{pim}
\end{eqnarray}
であるが、式(\ref{sumpi1})より
\begin{eqnarray}
\sum_{m=1}^K \pi_m &=& 1
\end{eqnarray}
であることを考えると
\begin{eqnarray}
\sum_{m=1}^K \pi_m &=& - \sum_{m=1}^K \frac{1}{\lambda} \sum_{n=1}^N \gamma_{n,m} &=& 1
\end{eqnarray}
でなければならず、変形してゆくと
\begin{eqnarray}
- \sum_{m=1}^K \frac{1}{\lambda} \sum_{n=1}^N \gamma_{n,m}
&=& - \frac{1}{\lambda} \sum_{m=1}^K \sum_{n=1}^N \gamma_{n,m} \\
&=& - \frac{1}{\lambda} \sum_{n=1}^N \sum_{m=1}^K \gamma_{n,m} \\
&& \text{式(\ref{sumgamma}) より } \sum_{m=1}^K \gamma_{n,m}=1 \text{ であるから} \nonumber\\
&=& - \frac{1}{\lambda} \sum_{n=1}^N 1 \\
&=& - \frac{N}{\lambda} \\
&=& 1
\end{eqnarray}
から
\begin{eqnarray}
\lambda &=& -N
\end{eqnarray}
従って式(\ref{pim})は
\begin{eqnarray}
\pi_m
&=& -\frac{1}{\lambda} \sum_{n=1}^N \gamma_{n,m} \nonumber\\
&=& \frac{1}{N} \sum_{n=1}^N \gamma_{n,m}
\end{eqnarray}
となる。
EMアルゴリズム
これまでに得た結果をまとめると
\begin{eqnarray}
\gamma_{n,m} &=& \frac{\pi_m N(\boldsymbol{x}_n|\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m)}{\displaystyle\sum_{k=1}^K \pi_k N(\boldsymbol{x}_n|\boldsymbol{\mu}_k,\boldsymbol{\Sigma}_k)} \nonumber
\end{eqnarray}
の下で、対数尤度関数の停留条件を満たすパラメータは
\begin{eqnarray}
\left\{
\begin{array}{rcl}
\boldsymbol{\mu}_m
&=& \frac{\displaystyle\sum_{n=1}^N \gamma_{n,m} \boldsymbol{x}_n}{\displaystyle\sum_{n=1}^N \gamma_{n,m}}, \\
\boldsymbol{\Sigma}_m
&=& \displaystyle\frac{1}{\displaystyle\sum_{n=1}^N \gamma_{n,m}} \displaystyle\sum_{n=1}^N \gamma_{n,m} (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T, \\
\pi_m
&=& \displaystyle\frac{1}{N} \sum_{n=1}^N \gamma_{n,m}
\end{array}
\right.\nonumber
\end{eqnarray}
であるが、$\displaystyle\sum_{n=1}^N \gamma_{n,m}$ は $m$ 番目の正規分布から出てきたサンプル数の推定値に相当するので、これを $N_m$ と書くことにすると、もう少し簡単になる。
\begin{eqnarray}
\left\{
\begin{array}{rcl}
\boldsymbol{\mu}_m
&=& \displaystyle\frac{1}{N_m} \sum_{n=1}^N \gamma_{n,m} \boldsymbol{x}_n,\\
\boldsymbol{\Sigma}_m
&=& \displaystyle\frac{1}{N_m} \sum_{n=1}^N \gamma_{n,m} (\boldsymbol{x}_n-\boldsymbol{\mu}_m)(\boldsymbol{x}_n-\boldsymbol{\mu}_m)^T,\\
\pi_m
&=& \displaystyle\frac{N_m}{N}
\end{array}
\right.
\end{eqnarray}
しかし $\gamma_{n,m}$ の計算式の中に $\boldsymbol{\mu}_m, \boldsymbol{\Sigma}_m, \pi_m$ が、 $\boldsymbol{\mu}_m, \boldsymbol{\Sigma}_m, \pi_m$ の計算式の中に $\gamma_{n,m}$ があるため、この連立方程式は非線形でスパッと解くことができない。そこで次のように初期値から出発して、E-step と M-step を交互に反復する EM アルゴリズムにより、対数尤度を非減少に保ちながら、初期値に依存する停留点へジワジワと近づけてゆく。
EMアルゴリズムの手順
- 初期値 $\boldsymbol{\mu}_m^{(0)}, \boldsymbol{\Sigma}_m^{(0)}, \pi_m^{(0)}$ を適当に設定し、$i=0$ とする
- $\boldsymbol{\mu}_m^{(i)}, \boldsymbol{\Sigma}_m^{(i)}, \pi_m^{(i)}$ を使い、$\gamma_{n,m}^{(i)}, N_m^{(i)}$ を計算する (E-step)
\begin{eqnarray}
\left\{
\begin{array}{rcl}
\gamma_{n,m}^{(i)} &=& \frac{\pi_m^{(i)} N(\boldsymbol{x}_n|\boldsymbol{\mu}_m^{(i)},\boldsymbol{\Sigma}_m^{(i)})}{\displaystyle\sum_{k=1}^K \pi_k^{(i)} N(\boldsymbol{x}_n|\boldsymbol{\mu}_k^{(i)},\boldsymbol{\Sigma}_k^{(i)})} \\
N_m^{(i)} &=& \displaystyle\sum_{n=1}^N \gamma_{n,m}^{(i)}
\end{array}
\right.
\end{eqnarray}
- $\gamma_{n,m}^{(i)}, N_m^{(i)}$ を使い、パラメータ $\boldsymbol{\mu}_m^{(i+1)}, \boldsymbol{\Sigma}_m^{(i+1)}, \pi_m^{(i+1)}$ を更新する (M-step)。$\boldsymbol{\Sigma}_m^{(i+1)}$ の計算には、先に求めた更新後の $\boldsymbol{\mu}_m^{(i+1)}$ を用いる
\begin{eqnarray}
\left\{
\begin{array}{rcl}
\boldsymbol{\mu}_m^{(i+1)}
&=& \displaystyle\frac{1}{N_m^{(i)}} \sum_{n=1}^N \gamma_{n,m}^{(i)} \boldsymbol{x}_n, \\
\boldsymbol{\Sigma}_m^{(i+1)}
&=& \displaystyle\frac{1}{N_m^{(i)}} \sum_{n=1}^N \gamma_{n,m}^{(i)} (\boldsymbol{x}_n-\boldsymbol{\mu}_m^{(i+1)})(\boldsymbol{x}_n-\boldsymbol{\mu}_m^{(i+1)})^T, \\
\pi_m^{(i+1)}
&=& \displaystyle\frac{N_m^{(i)}}{N}
\end{array}
\right. \label{update}
\end{eqnarray}
- パラメータ $\boldsymbol{\mu}_m^{(i+1)}, \boldsymbol{\Sigma}_m^{(i+1)}, \pi_m^{(i+1)}$ で対数尤度関数
\begin{eqnarray}
\log p(\boldsymbol{X}|\boldsymbol{\pi}^{(i+1)},\boldsymbol{\mu}^{(i+1)},\boldsymbol{\Sigma}^{(i+1)})
&=& \sum_{n=1}^N \log \sum_{k=1}^K \pi_k^{(i+1)} N(\boldsymbol{x}_n|\boldsymbol{\mu}_k^{(i+1)},\boldsymbol{\Sigma}_k^{(i+1)})
\end{eqnarray}
を計算し、十分収束したら終了する。さもなくば $i\leftarrow i+1$ としてステップ 2 に戻る
図3: 図1の散布データに EM アルゴリズムを適用した収束過程。初期値(反復0)では等方的な3つの正規分布が外れた位置にあるが、E-step と M-step を反復するごとに各分布が移動・回転・伸縮し、3つのクラスタへ吸い付いていく。各点の色はその反復での負担率 $\gamma_{n,m}$(3成分色の混合)を表し、収束につれて明瞭に分かれる。対数尤度は反復ごとに非減少である。[前へ][自動再生][次へ](およびスライダー)で各反復を切り替えられる。
注意
EM アルゴリズムは、任意の初期値から出発して大域的最適解に収束するとは限らない。
また、$N_m^{(i)}$ が小さい成分では $\boldsymbol{\Sigma}_m^{(i+1)}$ が特異行列に近づき、$\boldsymbol{\Sigma}_m^{-1}$ や $|\boldsymbol{\Sigma}_m|$ の計算が破綻することがある。実装では $\boldsymbol{\Sigma}_m$ に微小な $\varepsilon\boldsymbol{I}$ を加えるなどして正定値性を保つ(EMアルゴリズムの収束性を参照)。
共分散更新に使う $\boldsymbol{\mu}_m$ について
式(\ref{update}) の $\boldsymbol{\Sigma}_m^{(i+1)}$ の計算には、同じ M-step で先に求めた $\boldsymbol{\mu}_m^{(i+1)}$(更新後の値)を用いる。
これは負担率 $\gamma_{n,m}^{(i)}$ を固定したもとで $Q$ 関数を $\boldsymbol{\mu}_m$ と $\boldsymbol{\Sigma}_m$ について同時に最大化した解であり、標準的な EM の更新式である。scikit-learn 等の主要ライブラリでもこの形が採用されている。
これに対し、旧値 $\boldsymbol{\mu}_m^{(i)}$ を使う次の形も見かける。
\begin{eqnarray}
\boldsymbol{\Sigma}_m^{(i+1)}
&=& \frac{1}{N_m^{(i)}} \sum_{n=1}^N \gamma_{n,m}^{(i)} (\boldsymbol{x}_n-\boldsymbol{\mu}_m^{\color{red}(i)})(\boldsymbol{x}_n-\boldsymbol{\mu}_m^{\color{red}(i)})^T
\end{eqnarray}
こちらは $Q$ 関数の同時最大化解ではなく、M-step 内で $\boldsymbol{\Sigma}_m \to \boldsymbol{\mu}_m$ の順に条件付き最大化を行う ECM (Expectation Conditional Maximization) アルゴリズム [Meng & Rubin, 1993] の一種と見なせる。
標準的な EM の収束証明は「M-step ですべてのパラメータを同時に最大化する」ことに依拠しているため、この逐次更新にはそのままでは適用できない。
しかし Meng & Rubin (1993) は、各条件付き最大化ステップで $Q$ を増加させれば全体として対数尤度が非減少となることを証明しており、この変種でも単調性は保たれる。
ただし 2 つの更新式が同じ点に収束するとは限らず、初期値によっては異なる局所解に落ちる。
EMアルゴリズムの収束性
この節では、EM アルゴリズムの各反復で対数尤度が単調に非減少であることを証明する。
対数尤度を ELBO(変分下界、Evidence Lower Bound)と KL ダイバージェンスに分解し、E ステップで KL ダイバージェンスがゼロとなるよう負担率を設定すること、M ステップで ELBO を最大化することにより、対数尤度が反復ごとに改善されることを示す。
EMアルゴリズムの各反復で対数尤度が単調に増加(正確には非減少)することを示す。
対数尤度の下界
$\boldsymbol{\theta}=\{\boldsymbol{\pi},\boldsymbol{\mu},\boldsymbol{\Sigma}\}$ をパラメータの集合、$\boldsymbol{Z}=\{z_1, z_2, \cdots, z_N\}$ を潜在変数の集合とする。
潜在変数 $\boldsymbol{Z}$ に関する任意の確率分布 $q(\boldsymbol{Z})$ に対して、対数尤度は次のように変形できる。
\begin{eqnarray}
\log p(\boldsymbol{X}|\boldsymbol{\theta})
&=& \log p(\boldsymbol{X}|\boldsymbol{\theta}) \underbrace{\sum_{\boldsymbol{Z}} q(\boldsymbol{Z})}_{=1} \\
&=& \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log p(\boldsymbol{X}|\boldsymbol{\theta}) \\
&& \text{条件付き確率の定義より } p(\boldsymbol{X},\boldsymbol{Z}|\boldsymbol{\theta}) = p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta}) p(\boldsymbol{X}|\boldsymbol{\theta}) \text{ であるから} \nonumber \\
&=& \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log \frac{p(\boldsymbol{X},\boldsymbol{Z}|\boldsymbol{\theta})}{p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta})} \\
&=& \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log \frac{p(\boldsymbol{X},\boldsymbol{Z}|\boldsymbol{\theta})}{q(\boldsymbol{Z})} \cdot \frac{q(\boldsymbol{Z})}{p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta})} \\
&=& \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log \frac{p(\boldsymbol{X},\boldsymbol{Z}|\boldsymbol{\theta})}{q(\boldsymbol{Z})}
+ \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log \frac{q(\boldsymbol{Z})}{p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta})} \\
&=& \mathcal{L}(q,\boldsymbol{\theta}) + \mathrm{KL}(q \| p)
\end{eqnarray}
ここで $\mathcal{L}(q,\boldsymbol{\theta})$ と $\mathrm{KL}(q \| p)$ は次のように定義した。
\begin{eqnarray}
\mathcal{L}(q,\boldsymbol{\theta})
&\triangleq& \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log \frac{p(\boldsymbol{X},\boldsymbol{Z}|\boldsymbol{\theta})}{q(\boldsymbol{Z})} \\
\mathrm{KL}(q \| p)
&\triangleq& \sum_{\boldsymbol{Z}} q(\boldsymbol{Z}) \log \frac{q(\boldsymbol{Z})}{p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta})}
\end{eqnarray}
$\mathcal{L}(q,\boldsymbol{\theta})$ は変分下界(ELBO: Evidence Lower BOund)または負の変分自由エネルギーと呼ばれる。
直接最大化が困難な対数尤度 $\log p(\boldsymbol{X}|\boldsymbol{\theta})$ の代わりに、この下界を最大化するのがEMアルゴリズムの基本的なアイデアである。
$\mathrm{KL}(q \| p)$ は $q(\boldsymbol{Z})$ と事後分布 $p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta})$ の間の Kullback-Leibler ダイバージェンス(KLダイバージェンス)であり、常に $\mathrm{KL}(q \| p) \geq 0$ が成り立つ(等号は $q(\boldsymbol{Z}) = p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta})$ のとき)。
したがって $\mathcal{L}(q,\boldsymbol{\theta})$ は対数尤度の下界となる。
\begin{eqnarray}
\log p(\boldsymbol{X}|\boldsymbol{\theta}) &\geq& \mathcal{L}(q,\boldsymbol{\theta})
\end{eqnarray}
この不等式は、$\mathcal{L}(q,\boldsymbol{\theta})$ が常に対数尤度以下であることを意味する。
対数尤度 $\log p(\boldsymbol{X}|\boldsymbol{\theta})$ を直接最大化するのは困難($\log$ の中に $\sum$ があるため)だが、
下界 $\mathcal{L}(q,\boldsymbol{\theta})$ を最大化することで間接的に対数尤度を増加させることができる。
これがEMアルゴリズムの基本的なアイデアである。
E-stepの解釈
E-step では、現在のパラメータ $\boldsymbol{\theta}^{(i)}$ を固定して、下界 $\mathcal{L}(q,\boldsymbol{\theta}^{(i)})$ を最大化する $q(\boldsymbol{Z})$ を求める。
$\log p(\boldsymbol{X}|\boldsymbol{\theta}^{(i)}) = \mathcal{L}(q,\boldsymbol{\theta}^{(i)}) + \mathrm{KL}(q \| p)$ において、左辺は $q$ に依存しないので、$\mathcal{L}$ を最大化することは $\mathrm{KL}(q \| p)$ を最小化することと等価である。
$\mathrm{KL}(q \| p) \geq 0$ であり、等号成立は $q(\boldsymbol{Z}) = p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta}^{(i)})$ のときなので、E-step の最適解は
\begin{eqnarray}
q^{(i)}(\boldsymbol{Z}) &=& p(\boldsymbol{Z}|\boldsymbol{X},\boldsymbol{\theta}^{(i)})
\end{eqnarray}
である。このとき $\mathrm{KL}(q^{(i)} \| p) = 0$ となり、下界が対数尤度に一致する。
\begin{eqnarray}
\mathcal{L}(q^{(i)},\boldsymbol{\theta}^{(i)}) &=& \log p(\boldsymbol{X}|\boldsymbol{\theta}^{(i)})
\end{eqnarray}
M-stepの解釈
M-step では、E-step で求めた $q^{(i)}(\boldsymbol{Z})$ を固定して、下界 $\mathcal{L}(q^{(i)},\boldsymbol{\theta})$ を最大化するパラメータ $\boldsymbol{\theta}^{(i+1)}$ を求める。
\begin{eqnarray}
\boldsymbol{\theta}^{(i+1)} &=& \arg\max_{\boldsymbol{\theta}} \mathcal{L}(q^{(i)},\boldsymbol{\theta})
\end{eqnarray}
最大化により $\mathcal{L}(q^{(i)},\boldsymbol{\theta}^{(i+1)}) \geq \mathcal{L}(q^{(i)},\boldsymbol{\theta}^{(i)})$ が成り立つ。
EMアルゴリズムの式(\ref{update}) は、負担率を $\gamma_{n,m}^{(i)}$ に固定したこの最大化問題を $\boldsymbol{\mu}_m,\boldsymbol{\Sigma}_m,\pi_m$ について解いたものである。$\boldsymbol{\Sigma}_m^{(i+1)}$ に更新後の $\boldsymbol{\mu}_m^{(i+1)}$ を用いるのはこのためであり、旧値 $\boldsymbol{\mu}_m^{(i)}$ を使う変種はこの $\arg\max$ を与えないので、以下の証明はそのままでは適用できない(前節の注を参照)。
対数尤度の単調増加性
以上より、各反復での対数尤度の変化を追跡すると
\begin{eqnarray}
\log p(\boldsymbol{X}|\boldsymbol{\theta}^{(i+1)})
&=& \mathcal{L}(q^{(i)},\boldsymbol{\theta}^{(i+1)}) + \mathrm{KL}(q^{(i)} \| p(\cdot|\boldsymbol{X},\boldsymbol{\theta}^{(i+1)})) \\
&\geq& \mathcal{L}(q^{(i)},\boldsymbol{\theta}^{(i+1)}) \\
&& \text{M-step で下界を最大化したので} \nonumber \\
&\geq& \mathcal{L}(q^{(i)},\boldsymbol{\theta}^{(i)}) \\
&& \text{E-step で } \mathrm{KL}=0 \text{ としたので} \nonumber \\
&=& \log p(\boldsymbol{X}|\boldsymbol{\theta}^{(i)})
\end{eqnarray}
したがって、EMアルゴリズムの各反復で対数尤度は単調に増加(非減少)する。
\begin{eqnarray}
\log p(\boldsymbol{X}|\boldsymbol{\theta}^{(i+1)}) &\geq& \log p(\boldsymbol{X}|\boldsymbol{\theta}^{(i)})
\end{eqnarray}
共分散行列の正則化($\boldsymbol{\Sigma}_m$ に $\varepsilon\boldsymbol{I}$ を加えるなど)により特異解を排除すれば対数尤度は上に有界となるため、上に有界な単調非減少列である対数尤度の値の列は収束する。
ただし $\varepsilon$ はデータのスケールに比べて十分小さく取る必要がある。$\varepsilon$ が大きいと M-step が $Q$ を最大化しなくなり、上で用いた単調性の論法が成り立たなくなる($\boldsymbol{\Sigma}_m \succeq \varepsilon\boldsymbol{I}$ の制約下で $Q$ を最大化する定式化にすれば単調性は保たれる)。
また、値の列が収束してもパラメータ列そのものの収束には追加の条件が要る。
そして、収束先が大域的最適解である保証はなく、局所最適解や鞍点に収束する可能性がある。
よくある質問
Q1. GMM(混合ガウスモデル)とは何か?
GMM(Gaussian Mixture Model, 混合ガウスモデル)とは、データの確率分布を複数の正規分布(ガウス分布)の重み付き和として表現する確率モデルである。各正規分布は平均・分散共分散行列・混合比をパラメータに持ち、EMアルゴリズムで推定する。
Q2. GMMは何に使われるか?
GMMはクラスタリング(データの自動分類)、異常検知、音声認識(話者モデリング)、画像セグメンテーション、密度推定などに広く使われる。K-meansと異なり、各データ点が複数クラスタに確率的に所属できるソフトクラスタリングが可能である。
Q3. GMMとK-meansの違いは何か?
K-meansは各データ点を最も近いクラスタに1つだけ割り当てるハードクラスタリングであり、ユークリッド距離に基づくため等方的で同程度の大きさのクラスタと相性がよい。GMMは各データ点の所属確率を計算するソフトクラスタリングであり、向きや大きさの異なる楕円状のクラスタも表現できる。
Q4. EMアルゴリズムとは何か?
EMアルゴリズム(Expectation-Maximization)は、隠れ変数を含む確率モデルのパラメータを最尤推定する反復法である。E-step(各データ点の負担率を計算)とM-step(パラメータを更新)を交互に繰り返す。各反復で対数尤度は非減少となるが、収束先は初期値に依存し、大域的最適解とは限らない。
参考文献
- C.M. Bishop, "Pattern Recognition and Machine Learning", Springer, 2006
- X.L. Meng and D.B. Rubin, "Maximum Likelihood Estimation via the ECM Algorithm: A General Framework", Biometrika, 80(2), pp.267-278, 1993
📚
統計・機械学習を専門書で学ぶ方へ
読んだ内容を記録し、エビングハウスの忘却曲線に基づいて最適なタイミングで復習することで長期記憶に定着させる、無料の読書記録アプリ
読書の森。